agent工作流中添加pdf解析功能
- agent
- 2026-09-02
- 66热度
- 0评论
需求分析
现在的ai模型被设计成原生支持文本或者文本加图像,但在人类看起来也就是文本加图像的pdf对于ai来说却像是天书。如果工作流中经常遇到pdf格式的文件,那让ai能够准确读懂pdf就会非常重要。下面介绍三种pdf解析方法,如果没有兴趣可以跳过,点击左侧目录的创建mineru skill.
pdf解析方法对比
直接丢给ai一个pdf文件,它大概率会尝试调用Python解析库 (如 PyMuPDF, pdfplumber)来解决问题。这种方法的缺点很明显,仅仅对于非图片型且是纯文本的pdf解析效果比较好。而如果带有图片或者pdf的排版比较复杂,那解析效果就很差,会影响工作流。
第二种方法,也是最推荐加入工作流的方法就是调用mineru等专用的pdf解析模型。这些模型可以识别pdf中的图像,复杂排版(比如表格、公式)等,解析完成返回markdown文件后非常适合喂给ai进行后续工作。并且mineru还是开源的,如果资源足够,完全可以本地部署避免数据泄露等风险。
第三种方法就是直接使用原生支持输入pdf的模型。像现在的谷歌,claude,gpt都有这种模型。效果肯定是最好的,但是门槛有点高,本文就不讨论了。
创建mineru skill
首先到官网MinerU创建一个api token, 创建的时候记下来这个token.
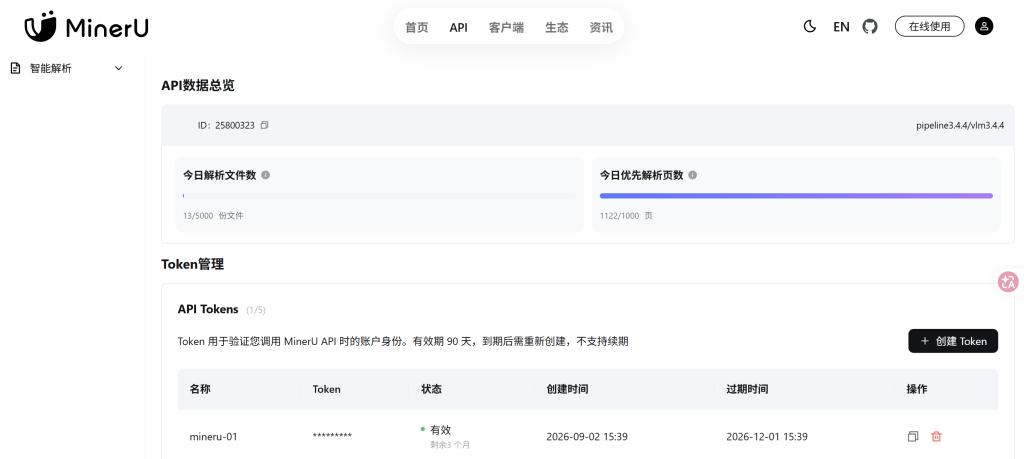
然后就可以通过和ai对话创建最适合自己的mineru skill.下面我介绍自己创建的skill(我的skills仓库 little-tiger001/skills: 整合我自己创建使用的skills 下面的mineru文件夹),如果你懒得自己创建,可以直接下载我的mineru文件夹到agent的skills目录下,不过会有一些注意事项,建议和ai沟通充分后决定是否使用。
- 前置条件,将mineru目录下的.env.example重命名为.env ,并将自己的mineru token输入到.env中
MINERU_TOKEN=后面。 - 触发条件:需要理解、阅读pdf 或者 解析pdf的时候
- 流程:先查看目标pdf文件是否已经被解析过,如果没有则开始解析。将解析出来的md文件放在工作空间下的.mineru文件夹下,重命名为目标文件在工作空间中的相对路径,比如,目标文件在工作空间中位置在 课件/0. 绪论.pdf,则解析后的md文件就在 .mineru/课件-0. 绪论.md。
- 注意事项:会在工作空间创建文件夹.mineru,如果是公共项目建议加入忽视或者提交前删除。
- 说明:重命名方便判断目标文件是否已经被解析过。
- 补充:这个skill非常简单,完全可以几轮对话让ai自己创建出来,或者在别人的skill基础上修改,适配自己的工作流。